1단계: 증상 파악
- Pod 이벤트에서 Read-only file system 에러 확인
kubectl describe pod <pod-name>
2단계: mount flag 확인 (참고용 — 100% 신뢰하지 말 것)
- rw로 나와도 실제 쓰기가 되는지는 별개이므로, 여기서 끝내지 않고 반드시 3단계로 진행
kubectl exec <pod-name> -- cat /proc/mounts | grep <제일 상단 경로>
3단계: Pod 내에서 직접 write 테스트 (가장 확실한 검증)
kubectl exec <pod-name> -- touch <마운트경로>/write-test
- 성공 → 다른 원인(subPath, securityContext, volumeMounts 순서 등)으로 좁혀서 재확인
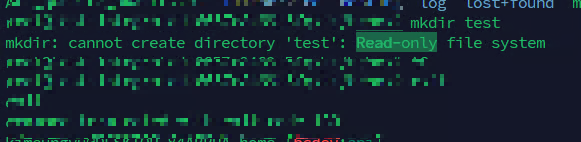
- Read-only file system으로 실패 → 4단계로
- 같은 PVC를 쓰는 다른 파드에서도 동일 테스트해서 특정 파드만의 문제인지, 볼륨 전체 문제인지 구분:
kubectl exec <같은 PVC 쓰는 다른 파드> -- touch <마운트경로>/write-test
4단계: share-manager 자체에서 확인 (Longhorn RWX인 경우)
# 담당 share-manager 찾기
kubectl -n namespace get volumes.longhorn.io <볼륨명> -o jsonpath='{.status.kubernetesStatus.pvcName}'

# export 경로에 직접 write 테스트
kubectl -n namespace exec share-manager-<볼륨명> -- touch /export/<볼륨명>/write-test

# 로그에서 I/O 에러 이력 확인
kubectl -n namespace logs share-manager-<볼륨명> | grep -iE "ERR_FSAL_IO|NFS4ERR_IO|posix2fsal_error"
5단계: 노드 커널 로그(dmesg)로 원인 확정
- share-manager가 떠있는 노드 확인 후 접속:
kubectl -n namespace get pod share-manager-<볼륨명> -o jsonpath='{.spec.nodeName}'
- 해당 노드에서
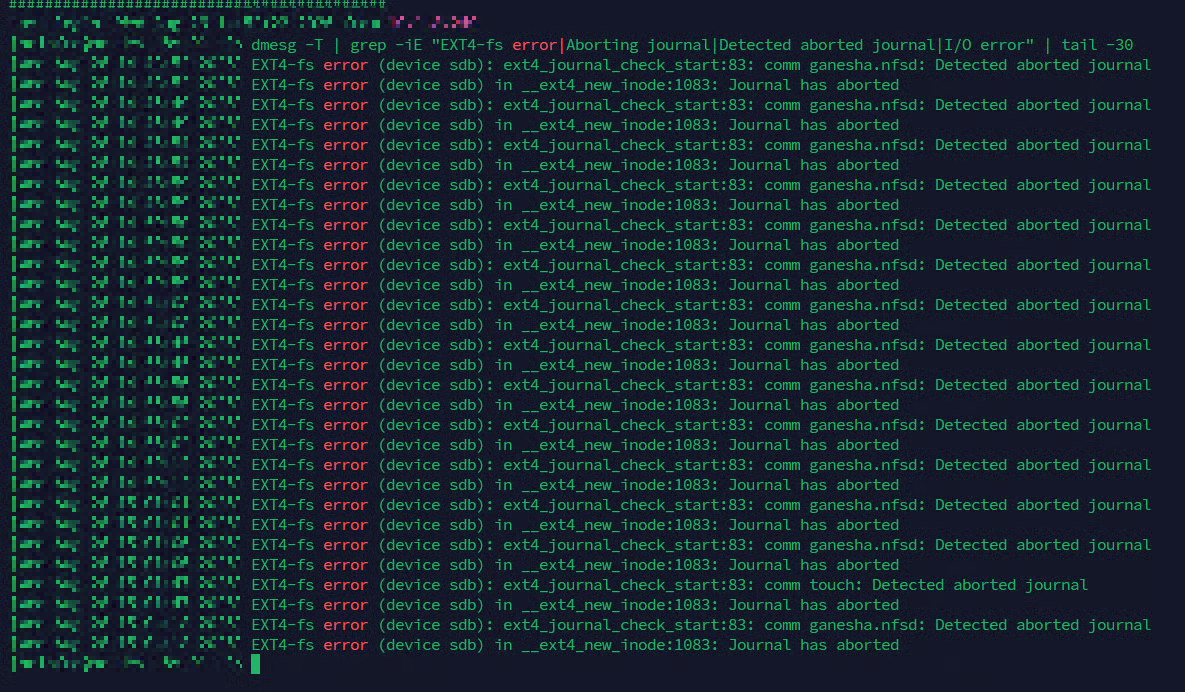
dmesg -T | grep -iE "EXT4-fs error|Aborting journal|Detected aborted journal|I/O error" | tail -30
Detected aborted journal이 보이면 원인 확정: ext4 저널 abort로 인한 EROFS
(여유 있으면) 최초 발생 시점 직전에 blk_update_request, Buffer I/O error 같은 실제 블록 I/O 에러가 있었는지 확인해서 디스크 하드웨어 문제인지도 판별 가능 — 급한 조치와는 별개로 재발 방지용
6단계: 판단 후 조치
- 저널 abort로 확정되면 → share-manager 재기동
kubectl -n namespace delete pod share-manager-<볼륨명>
- Longhorn이 자동 재생성 → 볼륨 재attach → ext4 완전 재마운트
7단계: 재기동 후 검증
- 성공하면 복구 확정 → 해당 PVC 쓰는 워크로드 전체 재시작 권장 (NFS 세션 재연결 안전성 확보)
kubectl -n namespace get pods -l longhorn.io/component=share-manager
# 1/1 Running 확인 후
kubectl -n namespace exec share-manager-<볼륨명> -- touch /export/<볼륨명>/write-test
kubectl -n namespace exec share-manager-<볼륨명> -- rm /export/<볼륨명>/write-test